GitHub 原生支持「堆叠 PR」:代码评审正在适应一口气写一千行的 Agent
GitHub 公开预览 Stacked Pull Requests——把互相依赖的 PR 堆起来分批评审。AI 一次改几百个文件的时代,评审流程不跟着变,人就成瓶颈了。
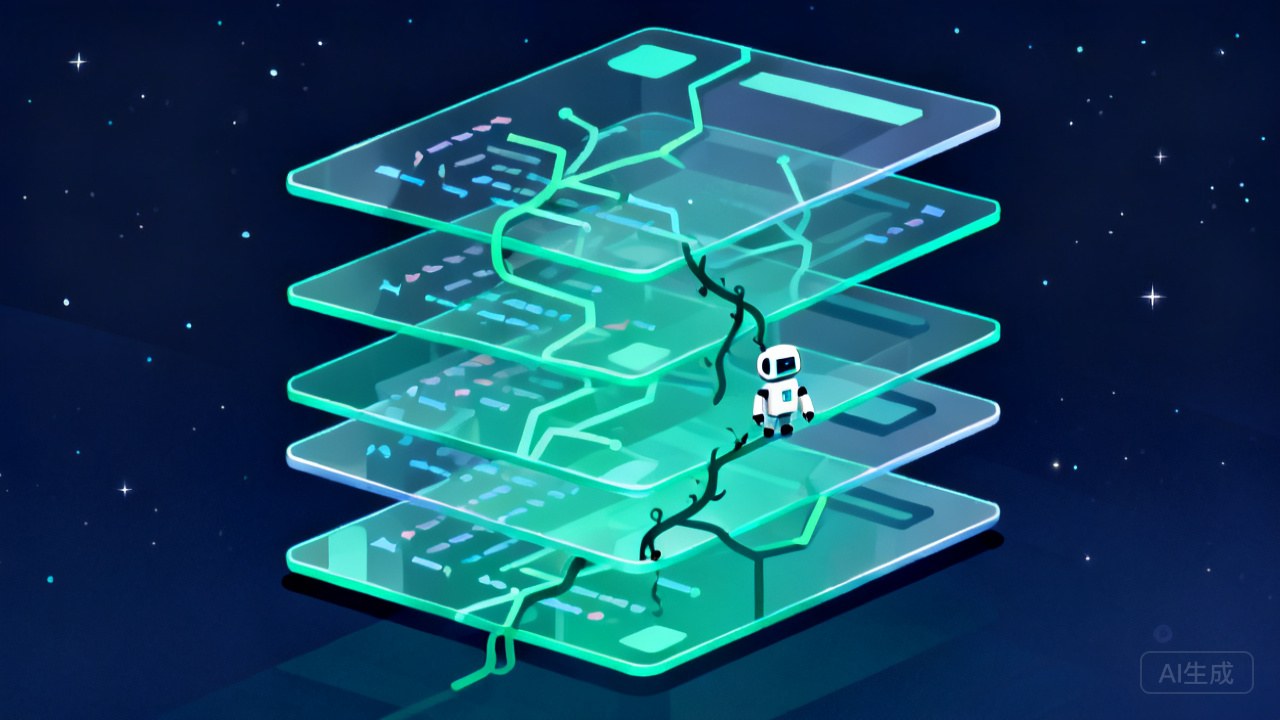
软件工程有个老规矩:PR 越小越好评审,最好一次只改一件事。可当 AI 编码 agent 一次提交几百个文件的改动时,这条规矩首先崩溃——没人能评审完一个「巨型 PR」。行业的解法这几年是「堆叠 PR」:把一大坨改动按依赖拆成一串小 PR,像多米诺一样逐层合并。过去这靠 Graphite 这类第三方工具,现在 GitHub 把它做成了原生功能。
综述
GitHub 公开预览 Stacked Pull Requests(堆叠式 PR):开发者可以把互相依赖的多个 PR 串成一条「栈」,每个 PR 基于栈中前一个 PR 的分支,评审与合并按序推进。预览阶段的定位很明确——为大改动提供「分批消化」的原生路径,而不必依赖外部工具或复杂的 rebase 流程。
这类工作流的核心逻辑是:改动 A 是改动 B 的前置依赖,B 又依赖 C……把它们按依赖序排成栈,每个 PR 相对前一个只多出「自己的那部分 diff」。评审者可以从小而清晰的单层看起,逐层推进;合并时从栈底开始,前一个合进去,后一个的 diff 自动变小。
堆叠不是新概念:Google 内部的 Critique、Meta 的 Phabricator 生态、以及创业公司 Graphite 都验证过这套模式的价值。GitHub 原生跟进的意义在于——它把这项能力从「少数团队的高级玩法」变成「默认平台能力」。
专业分析
要理解 GitHub 为什么现在做这件事,得先看工作负载的变化。代码评审的瓶颈,正从「写代码的速度」转移到「看代码的速度」。 AI agent 让「产生 diff」变得几乎免费:一次重构、一次跨模块改造,agent 可以在几小时内产出人类几周的改动量。但评审还是人在做——人的阅读带宽没有增长。
巨型 PR 的真正成本不只是「看不过来」,而是评审质量塌方:改动越大,reviewer 越倾向于只看整体、放过细节;上下文在文件间跳跃,缺陷更容易漏过去。堆叠 PR 把大 diff 切成依赖有序的小 diff,等于给评审者搭了脚手架——每一层都能完整理解,问题在每一层被拦住,而不是攒到最后一次性爆炸。
它还有一个常被忽略的好处:并行与解耦。栈里的 PR 各自对应一个功能点,作者可以按层推进,reviewer 可以按层认领,合并冲突被压缩到层间边界。对「一个 agent 负责一个大 feature、多人协同评审」的新协作模式,这是更匹配的容器。
代价也要说清楚:堆叠 PR 对分支纪律要求高——层与层之间的依赖要保持线性清晰,rebase 时机不对就会把栈搅乱;对新手团队,学习曲线比「一个大 PR」更陡。它是给「已经知道自己在干什么」的团队用的工具。
关联信息与影响
GitHub 做堆叠 PR 的时间点很说明问题:正值 AI 编码 agent(如 Kiro Crew 这类并行 coding agent、各家内置 agent 的 IDE)把单次改动规模推上新高。平台层在集体适应「AI 高产」的新常态——不是限制 AI 的产出,而是给产出配好消化的管道。
这条情报与「agent 并行化」的趋势互为表里:AWS Kiro Crew 让多个 coding agent 后台并行跑任务,GitHub 让并行产出的结果可以被有序评审——一个管生产,一个管质检,合起来才是完整的 AI 编码工作流。
对第三方工具的冲击也直接:Graphite 等堆叠 PR 创业公司要重新回答「我比原生功能多什么」——可能的答案在更深的集成(自动 rebase、跨仓库栈、与 agent 工具的联动)。对 CI/CD 生态,按层构建与按层保护分支会成为新的配置模式。
未来展望
短期,看预览转正的速度与交互打磨:栈的可视化、依赖冲突的自动处理、以及和 Code Review 流程(评审指派、规则集)的原生整合。
中期,堆叠 PR 大概率成为 AI 编码时代的默认评审协议——届时「PR 大小」的度量会从「行数」变成「逻辑层数」,评审文化也会随之改写。
长期,真正的终局可能是「评审自动化」:agent 写、agent 初评、人审关键层。堆叠 PR 恰好为这种分层信任提供了结构——每一层都可以被不同程度地自动化把关,人在最高风险的几层保留决定权。
信号强度
大模型厂商:编码 agent 的产出会更容易进入真实项目主干——降低「AI 改的代码没人敢合」的落地阻力,对 agent 编程的商业化是直接利好。
研究者:为「AI 代码产出的人类评审成本」提供了新的研究切口——分层评审下的人机分工、缺陷拦截率对比,都是可做实验的题目。
开发者:需要重新学习分支组织方式,但换来的是一次评审负担的大幅下降;对高频使用 agent 的开发者,这是生产力层面的实打实改善。
技术管理者:评审排期与质量门禁可以按层设计,不再被「等一个大 PR」卡住流程;度量体系(如评审周期、缺陷逃逸率)需要跟着调整。
关联产业链:第三方堆叠工具承压转型;CI/CD、代码质量平台需要适配按层构建;AI 编码工具的「提交策略」功能会成为新的差异化卖点。
代码评审的本质,是让「人脑」在关键处把关。AI 把代码产量放大了十倍之后,把关的方式必须从「一次看完」变成「分层看完」——GitHub 这一手,是在给未来十年的人机协作编码打地基。
devtool/GitHub Stacked Pull Requests(AI 情报库 2026-08-25 收录)
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://www.infoq.cn/article/zdc3HzpvqA96jwWA6lGb(InfoQ)